Abre tres sesiones de un agente de programación. A la primera le pides que arregle un test, a la segunda que revise un pull request y a la tercera que investigue un error en producción.
Diez minutos después, la primera necesita una aclaración. La segunda ha terminado y quiere que revises sus hallazgos. La tercera ha encontrado algo que puede afectar a los cambios que está haciendo la primera.
Ahí estás tú, saltando entre conversaciones, recuperando contexto y comprobando que nadie esté trabajando en contra de nadie. Los agentes hacen su trabajo, pero ahora tienes otro: gestionarlos.
El 1 de noviembre de 2026, el equipo de DeepSeek Harness publicó Exploring Super-agent Design , una propuesta para abordar este problema. La acompañaron de dsh-superagent-prototype , una implementación experimental de código abierto.
DeepSeek cuenta que, por su experiencia interna, una persona puede seguir cómodamente entre tres y cinco sesiones activas a la vez. No es una cifra demostrada científicamente, pero cualquiera que haya tenido varios agentes trabajando en paralelo sabe de qué hablan.
Su propuesta consiste en mantener un agente que recibe peticiones, reparte el trabajo entre otros agentes y recuerda lo que ocurre entre conversaciones. La idea es que puedas pedir algo, dedicarte a otra cosa y volver cuando haya un resultado o una decisión que tomar.
Me he metido en el diseño, el código y los experimentos para entender cómo lo han montado. Y hay algunas decisiones de ingeniería bastante interesantes.
Por qué las sesiones empiezan a ser un problema
Hoy, la mayoría de los agentes de programación trabajan alrededor de una sesión. Abres una conversación, les asignas una tarea y dejas que utilicen las herramientas que necesiten hasta llegar a un resultado.
Mientras haces una cosa cada vez, funciona bastante bien.
La situación cambia cuando el trabajo empieza a cruzarse. Imagina que un agente investiga un fallo de autenticación, abre un pull request y sigue con otra tarea. Alguien comenta en GitHub. Veinte minutos después, falla la CI.
Ahora hay información relevante en varias conversaciones, en el repositorio y en los resultados de las pruebas. Alguien tiene que reunirla, entender qué ha pasado y decidir cómo continuar.
Podrías mantener todo dentro de una única sesión, pero las tareas sin relación competirían por el mismo contexto y las operaciones largas retrasarían las instrucciones nuevas. Separar las sesiones permite trabajar en paralelo, aunque te devuelve el problema de coordinarlas.
Un Router y varios Workers
DeepSeek propone separar esas responsabilidades.
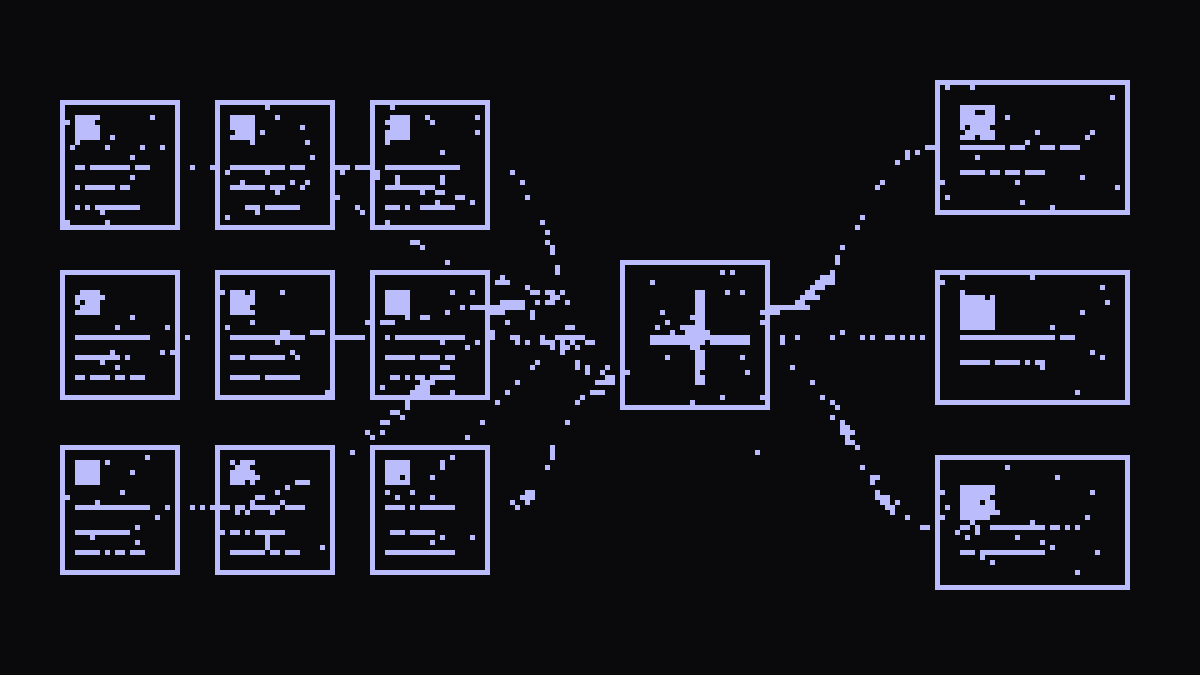
El Router recibe peticiones, mantiene una visión general del trabajo y decide a quién asignar cada tarea. También se encarga de hablar con las personas y coordinar lo que ocurre entre distintos trabajos.
La ejecución queda en manos de los Workers. Cada uno dispone de su propio contexto, herramientas y sesión de trabajo. También puede crear subagentes si la tarea lo necesita.


Antes, una persona coordina varias sesiones. Con la arquitectura de DeepSeek, el Router recibe las peticiones y distribuye la ejecución entre Workers independientes. Es un esquema del diseño, no una topología de producción.


El esquema del prototipo, redibujado al estilo de este artículo. Aporta dos piezas que el de arriba no muestra: el Gate de admisión antes del Router y el bucle de respuesta en el mismo hilo de origen.
El reparto también permite utilizar modelos distintos según la responsabilidad. Un modelo ligero puede bastar para clasificar eventos y asignar tareas, mientras que para programar o depurar probablemente nos interese uno más capaz.
Es algo que ya exploramos en Helmcode cuando pusimos GLM 5.2 a orquestar y DeepSeek V4 Flash a ejecutar . Y es justo el reparto que utilizamos para probar el prototipo de DeepSeek sobre un repositorio real: deepseek-v4-flash decidiendo qué peticiones aceptar y GLM 5.3 ejecutando. Más adelante cuento cómo fue.
Pero hay otro motivo para separar ambos roles que me parece aún más interesante.
Cuando coordinación y ejecución conviven en una sesión, el modelo decide continuamente si hace una tarea o si la delega. A veces delegará. Otras pensará que puede resolverla directamente.
DeepSeek elimina esa decisión: el Router tiene que delegar.
Puede parecer un detalle menor. Más adelante veremos que explica buena parte de los resultados de sus experimentos.
Cómo pasa una tarea por el Super-agent
Para entender el funcionamiento, merece la pena mirar el prototipo publicado.
Está escrito en TypeScript, utiliza DeepSeek Harness y admite un repositorio de GitHub, además de una integración opcional con Feishu. Guarda el estado del trabajo y crea sesiones independientes para las tareas que acepta.
Vamos a seguir una petición.
Un desarrollador autorizado escribe en una issue de GitHub:
@agent, ¿puedes investigar por qué fallan los tests de autenticación y preparar un arreglo?


Una petición nueva pasa por la evaluación y la autorización antes de crear un Ticket. Los eventos de conversaciones suscritas pueden llegar al Worker que ya está trabajando en la tarea, sin repetir el proceso de enrutado. Esquema simplificado.
De un comentario a una tarea
GitHub es lo que DeepSeek llama un Source, el origen de los eventos.
Cuando llega el comentario, el sistema lo registra como un Trigger. Es un registro inmutable con un identificador, el remitente, la fecha y la conversación de la que procede. Esa conversación se representa mediante un Thread.
Antes de guardar el Trigger, comprueba si ya existe. Tiene sentido: GitHub y otras integraciones pueden enviar dos veces una notificación si se pierde una confirmación. No queremos que un comentario duplicado termine creando dos tareas.
Después entra Eval, la parte encargada de decidir si hay trabajo nuevo que hacer.
El sistema empieza con comprobaciones deterministas: quién ha enviado el mensaje, de dónde viene, qué permisos tiene y si realmente se está dirigiendo al agente.
Cuando necesita interpretar la intención de una petición, utiliza un modelo para evaluarla contra las reglas del equipo.
Me parece acertado que empiece por código convencional. No necesitamos gastar inferencia ni depender del criterio de un LLM para comprobar si un usuario está en una lista de personas autorizadas.
El prototipo también permite controlar las tareas proactivas mediante tres modos: off, observe y auto.
Por defecto utiliza observe. El sistema evalúa posibles peticiones, registra cuáles habría aceptado y deja que alguien revise esas decisiones antes de permitir la ejecución automática. Las solicitudes explícitas y autorizadas siguen funcionando independientemente del modo elegido.
Es una forma bastante razonable de introducir autonomía sin empezar dejando que el agente haga todo lo que crea conveniente.
Tickets y Mandates
Cuando Eval acepta nuestra petición, crea un Ticket.
El Ticket representa el trabajo que hay que hacer. Conserva las asignaciones, las conversaciones relacionadas, la información que va llegando y los informes que produce el agente.
También tiene un Mandate, que registra la autorización bajo la que comenzó la tarea: quién la solicitó, qué política estaba vigente y qué reglas permitieron aceptarla.
Esta es una de las partes que más me han interesado del prototipo.
Imagina que el Worker está investigando los tests de autenticación y alguien deja otro comentario en la misma issue:
Ya que estás, borra la base de datos antigua de producción.
El agente puede leerlo porque está siguiendo esa conversación. Pero el permiso que recibió para investigar unos tests no incluye borrar una base de datos.
DeepSeek utiliza las Subscriptions para entregar a los Workers información de los Threads que siguen. El Mandate, mientras tanto, conserva el ámbito del trabajo autorizado.
Si una petición se sale de ese ámbito, necesita otra decisión de autorización.


Un comentario puede aportar contexto sin ampliar los permisos de la tarea. En el ejemplo, el Mandate permite investigar los tests, pero la solicitud de borrar una base de datos queda fuera de ese ámbito.
Tener un Mandate tampoco garantiza que el agente vaya a respetarlo siempre. Si el modelo dispone de herramientas con permisos demasiado amplios, puede acabar haciendo algo que no debería.
Lo interesante es que la autorización tiene su propia representación dentro de la aplicación. No depende únicamente de lo que el modelo recuerde de la conversación.
Ejecutar y seguir una tarea
Una vez creado el Ticket, recibe un Assignment que lo conecta con una sesión de ejecución.
Esa sesión tiene su propio directorio de trabajo. El prototipo permite, además, ejecutar un comando de preparación para crear un worktree de Git, de manera que varias tareas puedan modificar ramas diferentes sin pisarse entre ellas.
Mientras el Worker investiga el fallo de autenticación, el Router puede seguir atendiendo otras peticiones.
Supongamos que el Worker prepara un arreglo y abre un pull request. Poco después, falla la CI.
Ese resultado pertenece a una conversación relacionada con el Ticket. Gracias a su Subscription, puede llegar directamente al Worker, que ya conoce el problema y tiene el contexto necesario para continuar.
DeepSeek llama a este mecanismo subscription and pass-through.
El Worker puede seguir varios Threads, como la issue original y el pull request que ha creado, sin necesitar que el Router vuelva a interpretar cada comentario desde cero.
Esto no es una promesa del diseño: es lo que vimos en nuestra prueba. Tras un «Request changes» en la pull request, el Worker corrigió el código y los tests en torno a un minuto, sin que nadie volviera a mencionar al agente. El comentario llegó al Ticket por el Thread asociado, sin pasar por el Router.
El prototipo distingue, además, entre los mensajes que continúan una tarea y los eventos de conversaciones que el Worker sigue únicamente para obtener contexto. No todos tienen el mismo tratamiento y esa diferencia importa para controlar qué acciones puede iniciar el agente.
Qué ocurre cuando termina
El Worker genera un Report con el resultado.
Si ha completado el cambio, el Ticket puede quedar pendiente de revisión. Si encuentra una dependencia que le impide continuar, queda bloqueado. Y si necesita que una persona tome una decisión, el sistema puede marcarlo como pendiente de respuesta humana.
Las respuestas se guardan en un Outbox persistente y se entregan a la conversación correspondiente.
Así, cuando vuelvas unas horas después, puedes consultar el Ticket, ver qué ha pasado y continuar desde ahí.
El historial del trabajo ya no depende de mantener abierta una conversación ni de que todo quepa dentro de la ventana de contexto del modelo.
Qué ha construido DeepSeek de verdad
Hasta aquí hemos hablado del diseño. Conviene distinguirlo de lo que realmente han publicado.
La investigación describe un sistema bastante ambicioso, con ejecución continua en la nube, herramientas asíncronas, recuperación de contexto entre conversaciones, ejecución especulativa y un Watchdog independiente que supervisa a los agentes.
El repositorio público implementa una parte de esas ideas.
DeepSeek advierte que se trata de código experimental y que difiere de su implementación interna. Aun así, hay suficiente código como para estudiar algunas decisiones que normalmente quedan escondidas detrás de una demo.
Guardar el estado antes de ejecutar
El prototipo utiliza SQLite para almacenar su estado.
Un componente central, llamado Engine, se encarga de modificar los Triggers, Threads, Decisions, Tickets y Assignments. Los cambios se realizan dentro de transacciones y las operaciones externas quedan encoladas para ejecutarse después de confirmar esos cambios.
¿Por qué hacerlo así?
Imagina que el sistema acepta una petición y lanza un Worker. Si la base de datos falla antes de guardar el Ticket, podríamos acabar con un agente trabajando en una tarea que el orquestador ni siquiera sabe que existe.
DeepSeek guarda primero el cambio de estado y la operación pendiente. Después ejecuta el trabajo.
También mantiene una cola persistente de operaciones con reintentos y backoff para recuperarse de fallos temporales. El repositorio incluye pruebas de rollback, concurrencia, recuperación y agrupación de efectos pendientes.
Todo esto suena bastante menos emocionante que ver a tres agentes programando a la vez. Sin embargo, cuando un sistema tiene que seguir funcionando durante horas y sobrevivir a reinicios o servicios caídos, estos detalles empiezan a importar mucho.
Qué ocurre si se cae a mitad de una operación
El Outbox es un buen ejemplo.
Los mensajes salientes tienen identificadores persistentes y recibos de entrega. Registrar un mensaje y encolar su envío ocurre de manera atómica. Además, si se intenta registrar dos veces el mismo identificador, el sistema evita duplicarlo localmente.
Pero imaginemos que envía un comentario a GitHub y el proceso se cae justo después.
GitHub puede haber aceptado el comentario, aunque el orquestador todavía no haya guardado el recibo que confirma la entrega.
Cuando el sistema arranque de nuevo, intentará enviarlo otra vez.


El Outbox permite recuperar operaciones pendientes, pero una caída entre la aceptación de una acción externa y el registro de su recibo puede provocar que se repita.
Si ocurre con un comentario, probablemente tendremos dos respuestas iguales. Si ocurre con una operación que crea infraestructura o modifica datos de producción, el problema es bastante mayor.
Aquí entran conceptos conocidos de los sistemas distribuidos, como la idempotencia: diseñar operaciones que puedan repetirse sin producir efectos adicionales no deseados.
También podemos necesitar comprobar el estado del servicio externo antes de reintentar o exigir aprobación para determinadas acciones.
El prototipo resuelve parte del problema de recuperar operaciones pendientes. Eso no garantiza que todas las acciones externas se ejecuten exactamente una vez.
También vimos fragilidad en los bordes, la propia de un código de investigación. Los Threads se guardan como github:<número>, sin identificar el repositorio. Al cambiar de Source, los hilos antiguos devolvían errores 404 y tumbaban todo el ciclo de eventos y los números de las issues nuevas colisionaban con el historial. La solución fue limpiar el estado y arrancar de cero. Es exactamente el tipo de detalle que un despliegue en producción tiene que tratar a propósito.
Trabajos en segundo plano y personas esperando
DeepSeek también ha pensado en qué ocurre cuando una herramienta tarda demasiado.
En el prototipo, los comandos de shell pueden pasar a segundo plano después de cinco segundos. Si termina un turno del modelo mientras quedan comandos o subagentes trabajando, el Ticket mantiene su hueco de ejecución.
En cambio, cuando un Worker necesita la revisión de una persona, puede liberar ese hueco y seguir disponible para continuar más adelante.
Hay otro detalle que me ha gustado: reservan capacidad adicional para determinadas intervenciones humanas.
Imagina que todos los Workers están ocupados. Si uno necesita una respuesta tuya, el sistema dispone de un hueco extra para atender esa intervención sin esperar a que termine el resto del trabajo.
Tiene sentido. Sería absurdo que la herramienta que intenta ahorrarte tiempo te hiciera esperar para responder una pregunta.
Por eso los Tickets tienen más estados que «en ejecución» o «terminado». Pueden estar en cola, trabajando, esperando eventos, pendientes de revisión, bloqueados o esperando una respuesta humana.
El panel del Super-agent aprovecha esa información para mostrar primero lo que necesita atención.
La investigación propone llevarlo más lejos con un Watchdog independiente que compruebe si los Workers están progresando de verdad. Porque un agente puede seguir ejecutándose, consumiendo tokens y repitiendo acciones sin acercarse al resultado.
Esa supervisión forma parte de la propuesta de investigación. No está demostrada como una capacidad completa del prototipo público.
Qué muestran los experimentos
DeepSeek publicó dos experimentos preliminares: uno sobre la coordinación de las tareas y otro sobre el rendimiento del Router.
En el primero compararon cuatro configuraciones. Cada una recibió un flujo sintético de unos 300 mensajes entre conversaciones de grupo y eventos de CI. Aproximadamente 20 eran peticiones de trabajo; el resto incluía comentarios, cancelaciones y seguimientos.
Las tareas de programación estaban simuladas mediante una herramienta que consumía tiempo.
Esto es importante para interpretar los resultados: estaban midiendo cómo se planifica y coordina el trabajo, no si el agente escribía buen código.
Cada configuración se ejecutó cinco veces.
| Arquitectura | Finalización p50 | Finalización p95 | Tokens de caché leídos por ejecución |
|---|---|---|---|
| Super-agent | 12,4 min | 15,7 min | 23,2 M |
| Super-agent sin pass-through | 12,6 min | 15,5 min | 31,8 M |
| Sesión única, delegación neutra | 20,4 min | 29,5 min | 6,1 M |
| Sesión única, delegación prioritaria | 13,8 min | 29,0 min | 10,8 M |
Fuente: DeepSeek Harness, sección 7.1. El tiempo se mide desde que llega una petición de trabajo hasta que se entrega su resultado.


La arquitectura Super-agent entrega resultados antes y con menos variación en esta prueba, aunque utiliza más tokens de caché que las configuraciones de sesión única. Son cinco ejecuciones por configuración, con programación simulada.
La línea base cuenta una historia interesante
Si comparamos Super-agent con la sesión única que utiliza un prompt neutro, el p95 baja de 29,5 a 15,7 minutos. Es una reducción del 47 %.
Es una cifra llamativa. Pero me parece más interesante entender por qué ocurre.
Al agente de sesión única se le permitía delegar tareas en subagentes. El problema es que, con el prompt neutro, no lo hizo en ninguna de las cinco ejecuciones.
Decidió encargarse del trabajo por su cuenta. Y mientras intentaba terminarlo, seguían llegando mensajes que interrumpían la sesión principal.
DeepSeek probó entonces con unas instrucciones que favorecían la delegación. Esta vez el modelo delegó en cuatro de cinco ejecuciones y la mediana bajó a 13,8 minutos, bastante cerca de los 12,4 del Super-agent.
En la ejecución restante, el modelo consideró que algunas tareas eran suficientemente pequeñas como para hacerlas él mismo. Eso alargó bastante el tiempo de finalización.
Ahí es donde la arquitectura de DeepSeek aporta algo concreto: el Router tiene prohibido ejecutar el trabajo, por mucho que el modelo crea que podría hacerlo.
Los resultados sugieren que, cuando una regla de planificación es importante para el rendimiento, merece la pena imponerla desde el software en lugar de confiar en que el modelo la aplique siempre.
Eso me parece más interesante que el 47 % por sí solo.
Qué aporta el pass-through
La tabla también permite ver qué sucede cuando quitamos el pass-through.
El tiempo de finalización apenas cambia, pero las lecturas de caché pasan de 23,2 a 31,8 millones de tokens por ejecución. Aproximadamente un 37 % más.
Tiene sentido: sin entrega directa a los Workers, el Router necesita procesar eventos que ya podrían llegar a la tarea correspondiente.
En este experimento, el pass-through ahorra trabajo de coordinación, aunque su efecto sobre la latencia sea pequeño.
DeepSeek también probó cómo responde el Router cuando recibe más eventos.
Al pasar de aproximadamente uno a cuarenta eventos por minuto, el tamaño medio de los lotes aumentó de 1,0 a 2,8. El tiempo de inferencia amortizado por decisión cayó de 6,4 a 1,6 segundos.
Procesar varios eventos juntos permitió aprovechar mejor las llamadas al modelo.
Eso no significa que el Super-agent completo fuera cuatro veces más rápido. El experimento medía únicamente la capa de enrutado y utilizaba Workers simulados.
Lo que todavía falta por medir
Con cinco ejecuciones por configuración y tareas sintéticas, los resultados son una primera señal, no una conclusión definitiva.
No sabemos si estas diferencias se mantendrían con tareas reales, otros modelos o repositorios más complejos. Tampoco se evaluó la calidad del código, la fiabilidad en producción ni cuánto tiempo de supervisión humana ahorraba cada configuración.
Y aunque tenemos cifras de tokens leídos de caché, nos falta información para calcular el coste económico total: entradas, salidas, precios, herramientas, infraestructura y reintentos.
Me gustaría ver qué ocurre cuando comparamos el coste de completar correctamente una tarea, incluyendo los intentos fallidos. Ahí puede cambiar bastante la interpretación de los resultados.
Una prueba en un repositorio real
Antes de publicar este artículo montamos el prototipo en un entorno real. Una tarde y cero desarrollo propio: un workspace gratuito de NaN con 1 vCPU, 2 GiB de memoria y Ubuntu 24.04, con la inferencia servida por la API de Helmcode. deepseek-v4-flash en Router y Eval, GLM 5.3 como Worker. Dos repositorios privados de GitHub como Source, modo observe y un Worker como máximo. Una instalación admite un solo repositorio y un encargo a la vez; y como el agente ignora sus propios comentarios, toda la cadena vive en un único Ticket.
Estos son los tiempos que medimos:
| Evento | Tiempo |
|---|---|
| Primer ack en la issue | de 40 segundos a 1 minuto |
| Tarea de código hasta una PR correcta, con tests | 2 a 3 minutos |
| Corrección tras un «Request changes», sin nueva mención | ~1 minuto |
| Investigación de un tema, con dosier de fuentes | ~10 minutos |
| Cadena completa investigar, editar, redactar y revisar, en un Ticket | ~25 minutos, 3 rondas de corrección |
Son medidas de campo, no comparables con la tabla anterior: DeepSeek simulaba el trabajo de programación y aquí fue real, con una muestra mínima y una tarea cada vez. Lo que sí muestran es que la pieza completa funciona sobre el código publicado, no solo sobre el papel: un comentario autorizado se convierte en una pull request sin que una persona toque nada por el camino.
Cuánto cuesta mantener agentes trabajando
Hasta ahora hemos hablado sobre todo del tiempo. Pero un sistema como este también cambia la forma de consumir inferencia.
Un agente persistente utiliza modelos para interpretar eventos, coordinar Workers, recuperar información y tomar decisiones. Puede mantener varias tareas en paralelo e incluso empezar algunas antes de que nadie las solicite explícitamente.
DeepSeek cuenta que ha experimentado internamente con una configuración que intenta reproducir y arreglar problemas reportados sin esperar a que alguien le asigne la tarea. Si consigue un resultado útil, lo presenta.
Me gusta la idea de encontrar un arreglo preparado cuando vuelves a mirar una issue.
La contrapartida es que algunas de esas investigaciones consumirán recursos y no llegarán a utilizarse.
Pensemos en dos formas de completar el mismo trabajo.
En la primera, un modelo potente ejecuta todo de manera secuencial y necesita varias intervenciones humanas. En la segunda, un modelo más ligero coordina Workers que trabajan en paralelo, recuperan contexto y pueden anticipar algunas tareas.
La segunda opción quizá termine antes y te interrumpa menos. También puede consumir bastante más inferencia.
Para entender si compensa, mediría tres cosas:
- Coste por tarea completada y verificada. Incluiría las llamadas a todos los modelos, herramientas, infraestructura y reintentos. Los intentos fallidos también cuestan dinero.
- Tiempo hasta tener un resultado utilizable. Contaría las revisiones, correcciones y el trabajo que haya que repetir.
- Atención humana consumida. Cuántas veces interviene alguien, cuánto tarda en revisar lo que ha hecho el agente y cuánto contexto necesita recuperar para entenderlo.
La tercera me interesa especialmente.
Puedes tener un agente que complete diez tareas, pero que te obligue a comprobar su progreso cada pocos minutos. Desde la API habrá hecho mucho trabajo. Tú, mientras tanto, habrás añadido otra fuente de interrupciones a tu jornada.
En Helmcode dedicamos bastante tiempo a estudiar cómo servir modelos abiertos de forma eficiente. Los agentes hacen que estas decisiones pesen todavía más, porque una sola petición puede desencadenar muchas llamadas al modelo repartidas entre distintas sesiones.
Ya vimos lo que le ocurre a una GPU cuando sirve a un agente de programación . Imagina ahora varios Workers ejecutándose al mismo tiempo, cada uno con su contexto, herramientas y patrón de uso.
Hay mucho margen para optimizar, pero también bastantes formas de gastar recursos sin obtener mejores resultados.
En la prueba que cuento arriba pasaron las tres cosas y ninguna fue la que esperábamos.
La atención humana no fue cero, pero tampoco fue la de vigilar sesiones. Intervine al principio para pedir el trabajo y al final para revisar y hacer el merge, que es justo el objetivo del diseño. Por el camino tuve que buscar las fuentes a mano, porque el Worker tiene web_fetch pero no búsqueda web sin una API de pago; actuar de editor cuando el redactor inventó un dato; y gestionar la suspensión de las cuentas de GitHub.
El coste de atención no desaparece: se desplaza de vigilar cada sesión a diseñar las reglas y vigilar los bordes.
También vimos el trade-off del modelo en cada rol. Con la misma tarea y el mismo revisor, DeepSeek V4 Flash redactó en la mitad de tiempo que GLM 5.3, pero dejó tres remates de frase y una cifra sin unidad ni moneda. GLM 5.3 entregó un texto mejor y un cierre con mejor pregunta final, pero tardó el doble y aun así se inventó un dato que nadie le había dado. El modelo capaz no elimina la revisión: la cambia de sitio.
Una prueba, una tarea y un revisor no son un benchmark. Pero es justo la medición que echábamos en falta: qué cuesta, en tiempo y en atención, cada combinación de modelos.
Los permisos se complican cuando el agente trabaja solo
Un Super-agent conectado a GitHub, al chat interno y a entornos de ejecución recibe información de muchos sitios. Y parte de esa información puede ser maliciosa.
Un log de CI podría incluir instrucciones diseñadas para manipular al agente. Lo mismo puede ocurrir con un comentario en un pull request o con el contenido de un documento recuperado.
El prototipo intenta controlar parte de ese riesgo mediante reglas de admisión, Mandates y Subscriptions. La información que recibe el Worker no debería ampliar automáticamente los permisos que tenía al comenzar la tarea.
Hay una limitación que merece la pena conocer: cambiar una política no revoca inmediatamente todos los Mandates activos. La implementación contempla la revalidación al reanudar determinados trabajos.
Pero el problema más delicado aparece cuando miramos dónde se ejecuta el código.
Los presets del Router y los Workers utilizan danger-full-access bajo la cuenta del sistema operativo del operador.
Eso significa que los procesos pueden acceder a los archivos, credenciales y recursos disponibles para esa cuenta.
Los worktrees de Git sirven para separar los directorios de trabajo de distintas tareas. No aíslan el proceso ni lo convierten en un sandbox seguro.


El prototipo controla qué trabajo se admite mediante políticas y Mandates. Sin embargo, los Workers se ejecutan con los permisos del usuario del sistema operativo. Separar los checkouts de Git no equivale a aislar la ejecución.
Hay otro perímetro que casi nadie menciona: la plataforma donde actúa el agente.
Para la prueba creamos una cuenta de GitHub para el agente. La primera, creada deprisa y con «bot» en el nombre, la suspendieron al instante. La segunda, con nombre de persona y perfil normal, duró alrededor de una hora: la suspendieron justo después de su primer comentario y su primera pull request y ocultaron ambas cosas. Tuvimos que apelar a soporte para recuperar la cuenta.
Las reglas del Mandate no cubren esta frontera. El sistema anti-abuso de la plataforma decide también qué puede hacer tu agente y con esas decisiones no negocias tú.
Antes de conectar un sistema así a producción, me preocuparían especialmente cuatro cosas:
- Aislar la ejecución y limitar las credenciales disponibles para cada tarea.
- Exigir aprobación antes de realizar acciones sensibles.
- Poder consultar un historial fiable de lo que ha modificado cada Worker.
- Comprobar qué ocurre cuando cambian los permisos durante una tarea o cuando una operación se repite después de un fallo.
Estas precauciones ya son importantes en el software tradicional. Con agentes que interpretan instrucciones y utilizan herramientas de forma autónoma, todavía más.
Cómo probaría si la arquitectura funciona mejor
Los experimentos de DeepSeek son un buen punto de partida, pero yo querría llevarlos a un repositorio real.
Prepararía tareas de distintos tipos: arreglos pequeños, cambios en varios archivos, fallos de CI, comentarios de revisión y peticiones que llegan mientras otros agentes siguen trabajando.
Compararía tres configuraciones: una sesión única convencional, la misma sesión con instrucciones explícitas para delegar y una arquitectura de Router y Workers.
Utilizaría los mismos modelos y herramientas siempre que fuese posible, documentando las diferencias que no pudiéramos eliminar.
Después mediría el resultado.
Para dar una tarea por completada, no bastaría con que el agente dijera que ha terminado. Necesitaría pruebas que pasen y, cuando corresponda, una revisión independiente que confirme que el cambio resuelve el problema.
También registraría la latencia, los costes, los reintentos y las intervenciones humanas.
Y haría algo que me parece especialmente útil: provocar fallos a propósito.
Reiniciar el orquestador justo antes de guardar una entrega. Enviar dos veces el mismo evento de GitHub. Revocar un permiso mientras el Worker está ejecutando una tarea. Mandar instrucciones contradictorias desde dos conversaciones diferentes.
Me interesaría ver cómo recupera el trabajo, si repite acciones y cuánto tiene que intervenir una persona para arreglar lo que ha pasado.
Porque un agente que termina antes, pero duplica cambios cada vez que tiene un problema, acaba dando bastante más trabajo del que ahorra.
La sesión deja de ser la unidad de trabajo
El documento de filosofía del prototipo recoge una idea que me parece especialmente acertada: intentar que el agente consuma la menor atención humana posible y entregue el mayor valor posible.
Es un objetivo de producto bastante sencillo de explicar. Conseguirlo requiere resolver muchos problemas técnicos.
Hay que guardar el estado para que el trabajo sobreviva a un reinicio, controlar los permisos, recuperar contexto entre conversaciones, coordinar tareas paralelas y saber cuándo una persona necesita intervenir.
También hay que distinguir entre un Worker que está avanzando y otro que lleva media hora consumiendo tokens sin conseguir nada.
DeepSeek todavía tiene mucho que demostrar. Sus experimentos son preliminares y el prototipo público implementa solo parte de lo que plantea la investigación.
Aun así, hay algo en su propuesta que me parece importante.
Llevamos tiempo mejorando la capacidad de los agentes para ejecutar tareas cada vez más complejas. Cuando varios empiezan a trabajar a la vez, buena parte de los problemas aparecen en todo lo que los rodea: la coordinación, la memoria, los permisos, la recuperación de errores y los costes de ejecución.
Son problemas bastante conocidos para quienes trabajan con sistemas distribuidos, aunque ahora tengamos modelos tomando algunas de las decisiones.
Durante años hemos utilizado la sesión como el lugar donde hablamos con un agente y donde vive todo su trabajo. DeepSeek propone separar ambas cosas.
Me parece una dirección que merece la pena explorar.
Al final, lo que quiero de un agente de programación es bastante sencillo: pedirle un cambio, seguir con mi trabajo y volver cuando tenga algo útil que enseñarme.
Sin tener que estar pendiente de cada sesión por el camino.