Probamos una arquitectura con reglas y Clef, el modelo de decisión de Cloudflare. DeepSeek pasó del 83 % al 100 % de éxito y superó a Claude Opus 5.5.
Qué hemos probado y por qué
Trabajamos con modelos abiertos todos los días y sabemos dónde son buenos, dónde no lo son y dónde pueden llegar a ser mejores que los modelos cerrados.
Por eso pedimos a nuestros colegas de Agent Swarm que nos ayudaran con una serie de experimentos para investigar cómo mejorar el rendimiento de los modelos abiertos cuando trabajan como agentes.
Agent Swarm es un software open source que proporciona una arquitectura en la que un modelo actúa como coordinador o agente principal (el *Lead*): descompone la tarea en subtareas y las reparte entre varios subagentes especializados, los *workers*, que las ejecutan en paralelo.
Queríamos saber cómo de bueno es DeepSeek coordinando y ejecutando un «enjambre» de agentes. Así que Eze y Taras , de Agent Swarm, probaron una arquitectura de coordinación que incorpora Clef como modelo decisor, junto con algunas reglas explícitas.
En el benchmark, DeepSeek consiguió 28 de 28 aciertos y Claude Opus 5.5, 28 de 30. Un 100 % de acierto que merece un análisis y una buena explicación del experimento. Puedes consultar todos los resultados del benchmark .
Entramos en el experimento
Sin Clef ni reglas, DeepSeek había conseguido un 83 % de acierto. Con los cambios, llegó al 100 %.
¿Qué cambiamos? No tocamos el modelo. Cambiamos cómo toma las decisiones el sistema que lo rodea.
Y nos parece un hallazgo muy importante para el ecosistema actual de modelos abiertos. La pregunta que nos hicimos fue: ¿hasta qué punto podemos conseguir mejores resultados con modelos abiertos optimizando su arquitectura, sin depender siempre de un modelo de frontera como coordinador?
Ejecutar y coordinar no es lo mismo
Un agente de programación recibe una tarea, investiga el repositorio, modifica archivos, ejecuta tests y entrega el resultado. Es algo que muchos ya hacemos a diario.
Pero ¿qué pasa cuando empiezas a introducir varios agentes?
Cuando pones a trabajar un enjambre de agentes, tienen que coordinarse para no repetir las mismas tareas ni modificar archivos que otro está tocando. Por eso aquí aparece una figura clave: el agente coordinador. Un agente que no necesita resolver problemas, sino decidir qué delegar, a quién, cuándo intervenir y cuándo dar una tarea por terminada.
Una mala decisión puede hacer que el equipo repita trabajo, se bloquee o entregue algo que no está bien.
Nuestra hipótesis es que estas decisiones son ortogonales al razonamiento general que aporta un LLM.
Extensiones como guardrails
La estrategia en estos casos es sencilla. Sistemas como Agent Swarm permiten crear controladores propios para tu organización, las extensiones. Se ejecutan incluso antes de que arranque tu harness favorito, son independientes y tan deterministas como quieras.
Con este planteamiento puedes añadir extensiones que validen la entrada o la salida de tu agente. En este caso, para evaluar o clasificar una decisión. En otros, para sanear lo que el agente ha visto en la web, proteger los datos de tus usuarios o cambiar herramientas sin que el agente se entere.
La arquitectura: qué aporta un modelo «System One» como Clef
Si has oído hablar de Jev, que supuso una pequeña revolución hace unos meses, es posible que conozcas Clef. Es el modelo de decisión de Cloudflare y es open source.
Lo importante es que funciona de forma distinta a un LLM generativo:
- Recibe información y un conjunto de respuestas posibles (categorías).
- Devuelve tres valores: la categoría, su probabilidad y un sí/no.
- Trabaja con menos contexto: Jev, por ejemplo, tiene un límite de entrada de 32.000 tokens.
- Es muy rápido: unos 200 ms por respuesta.
- Es pseudodeterminista: para la misma entrada, siempre devuelve lo mismo.
El último punto es fundamental. Con entradas estructuradas que se repiten, puedes aprender cuáles son los casos en los que se equivoca, aunque su confianza sea alta.
Un ejemplo
Imagina que un agente coordinador tiene tres workers trabajando. Uno termina su tarea, otro sigue ejecutando y el tercero se ha bloqueado.
El sistema tiene que decidir si espera, interviene o reasigna el trabajo. Tres respuestas posibles: una clasificación sencilla. Ese es el tipo de decisión estructurada en el que Clef brilla.
La arquitectura que probamos
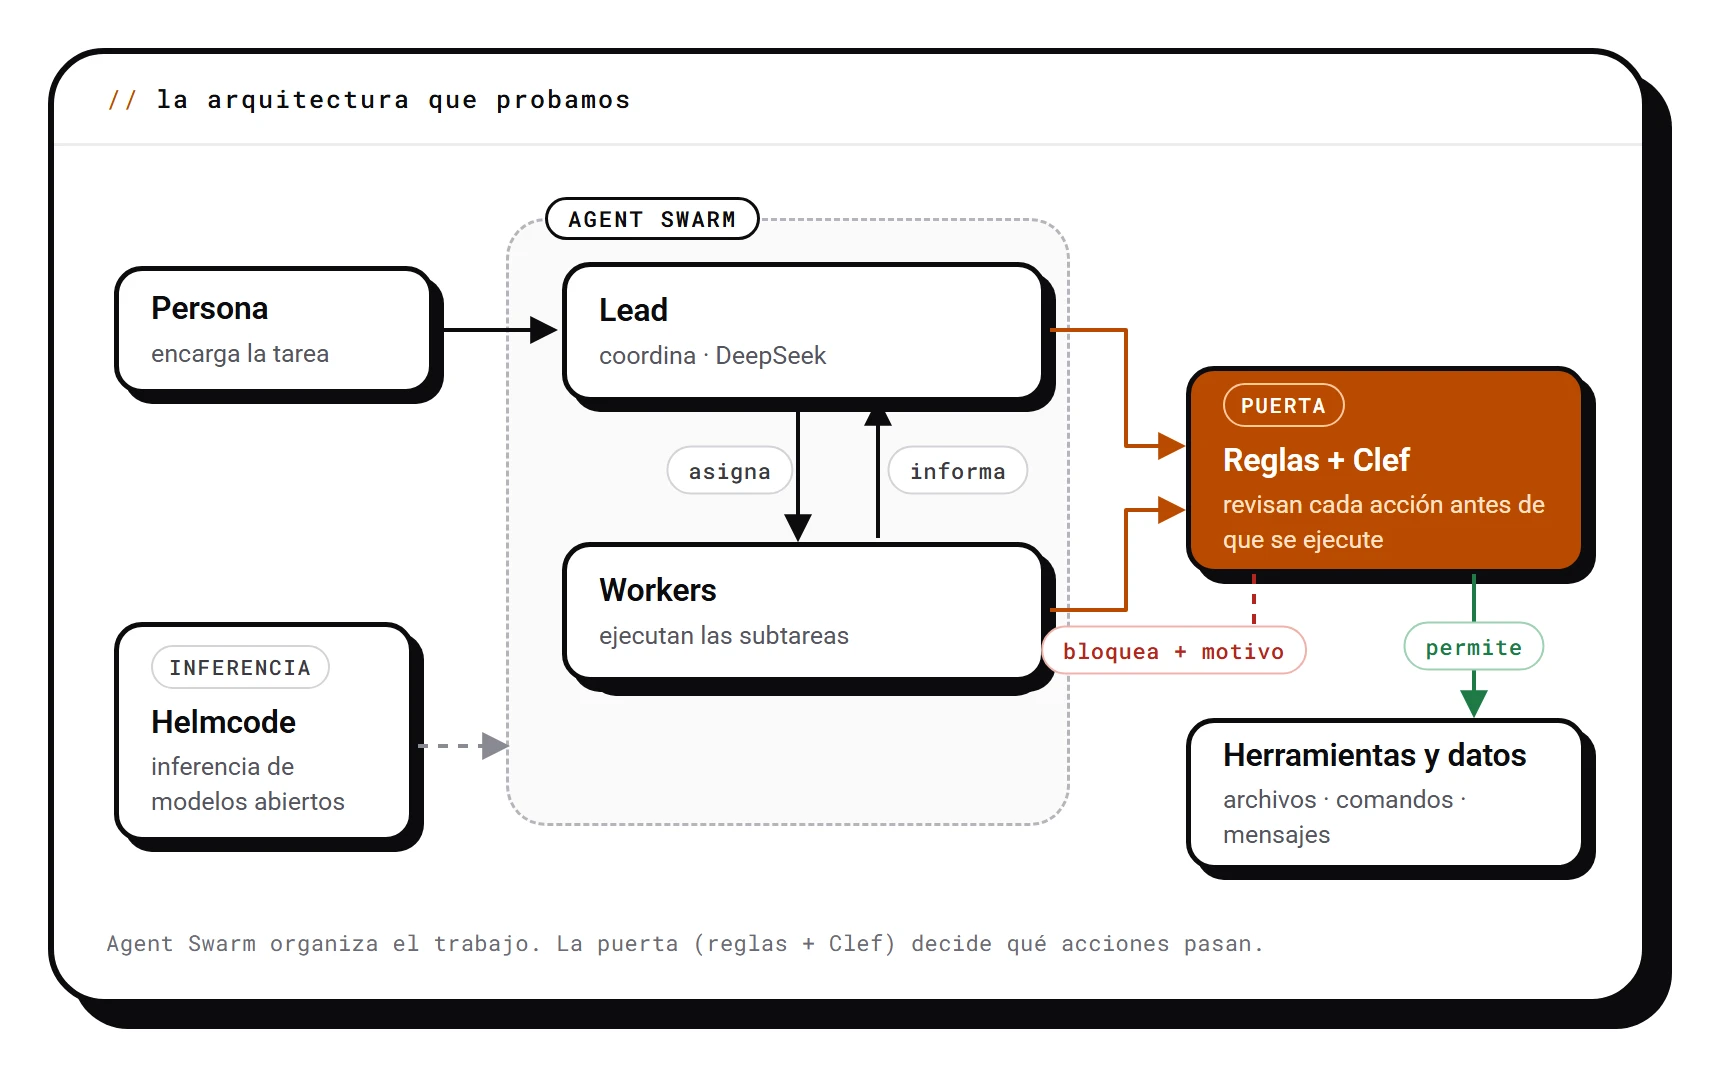
Agent Swarm incorporó reglas explícitas para asegurarse de que el Lead delegaba con claridad, en las herramientas adecuadas y de forma válida. Así, Clef daba feedback directo y rápido al sistema de coordinación.
- Agent Swarm organiza el trabajo.
- DeepSeek actúa como modelo principal.
- Las reglas y Clef supervisan determinadas decisiones.
- Los workers ejecutan las tareas.
- Helmcode sirve la inferencia de los modelos abiertos.
Cada vez que un agente propone una acción, la puerta resume el contexto en un máximo de unos 1.000 tokens y Clef responde a tres preguntas. Si todas salen bajas, la acción se ejecuta. Si alguna sale alta, se bloquea y el agente recibe el motivo.
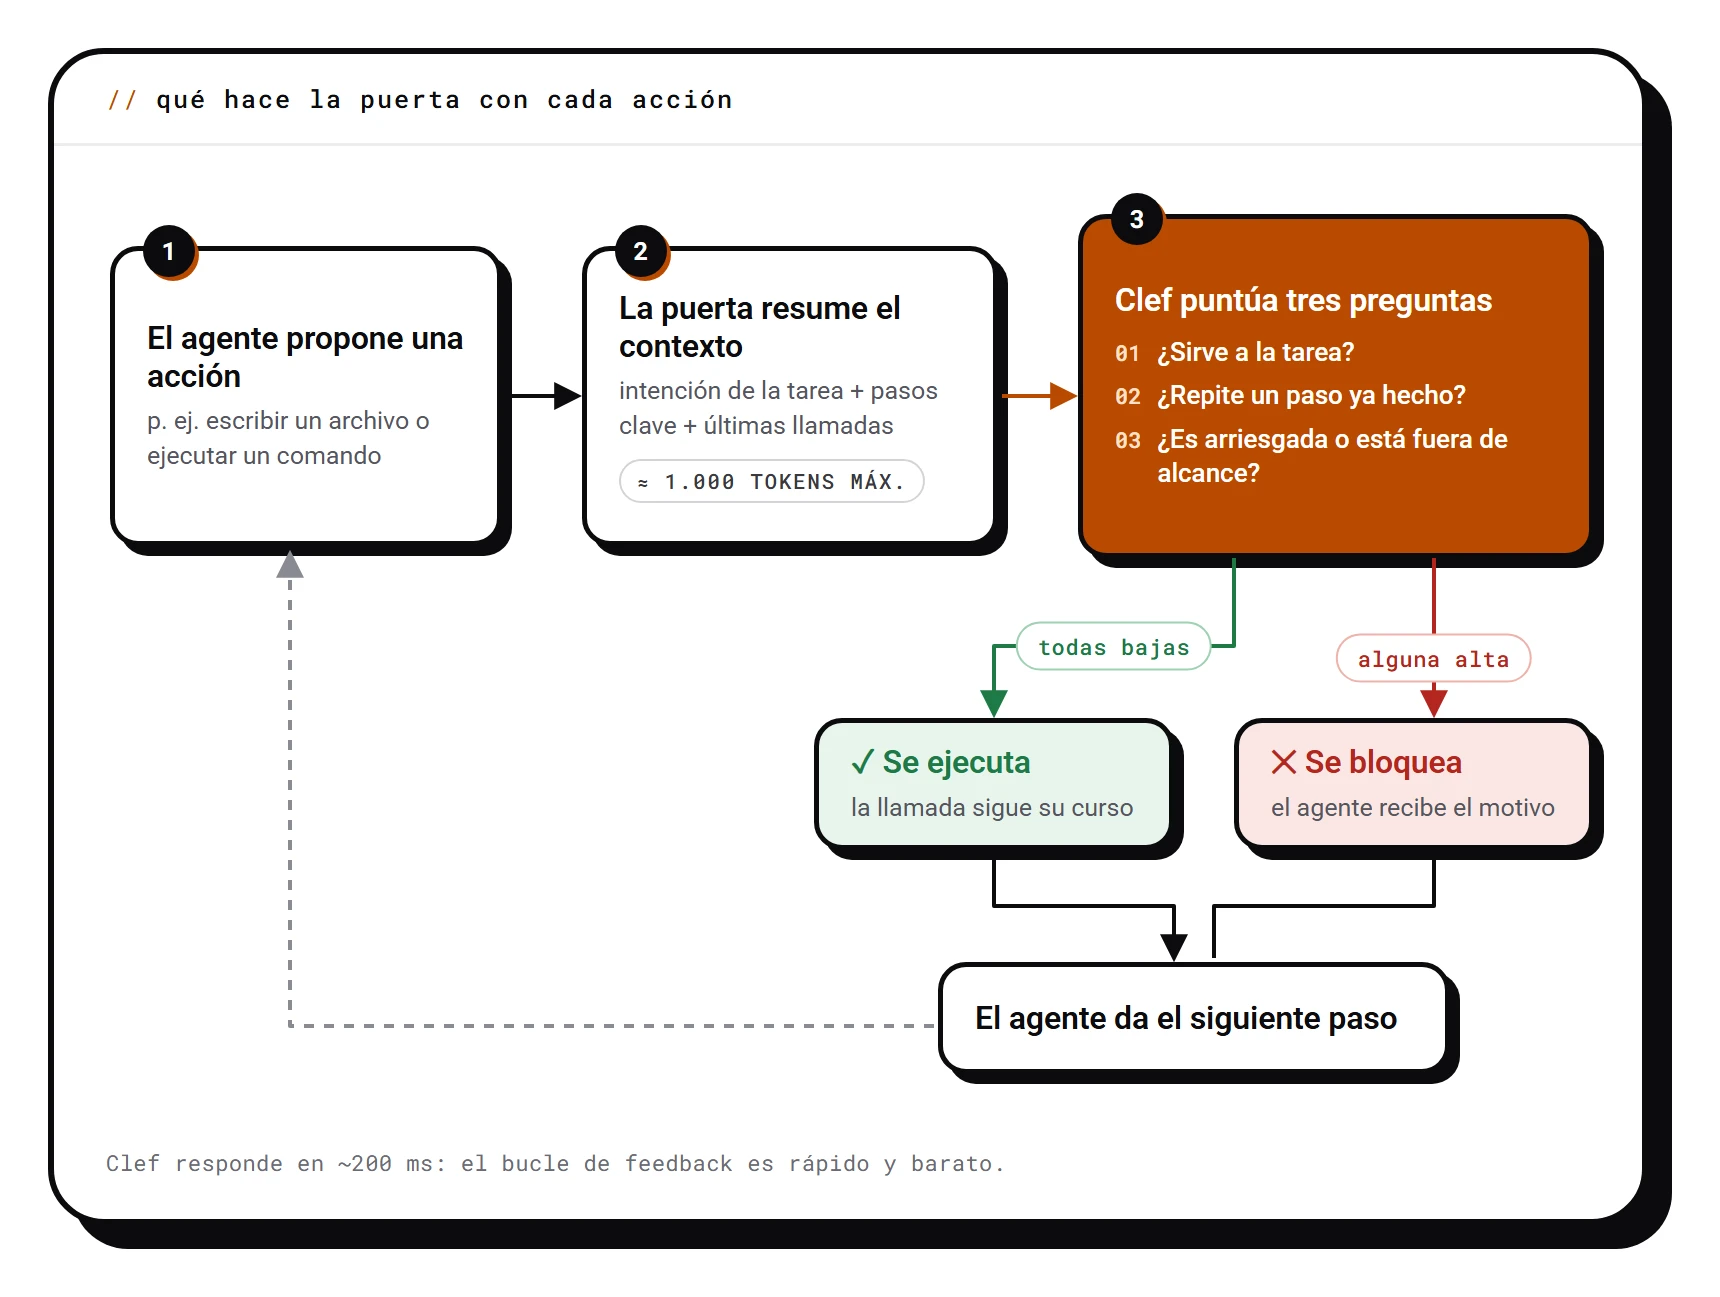
Para el Lead hay además una regla fija: no puede leer él mismo los registros de la tarea. Si lo intenta, la lectura se bloquea y tiene que delegarla en un worker. Cualquier otra lectura pasa por Clef, que decide si tiene sentido que el Lead la haga en ese momento.
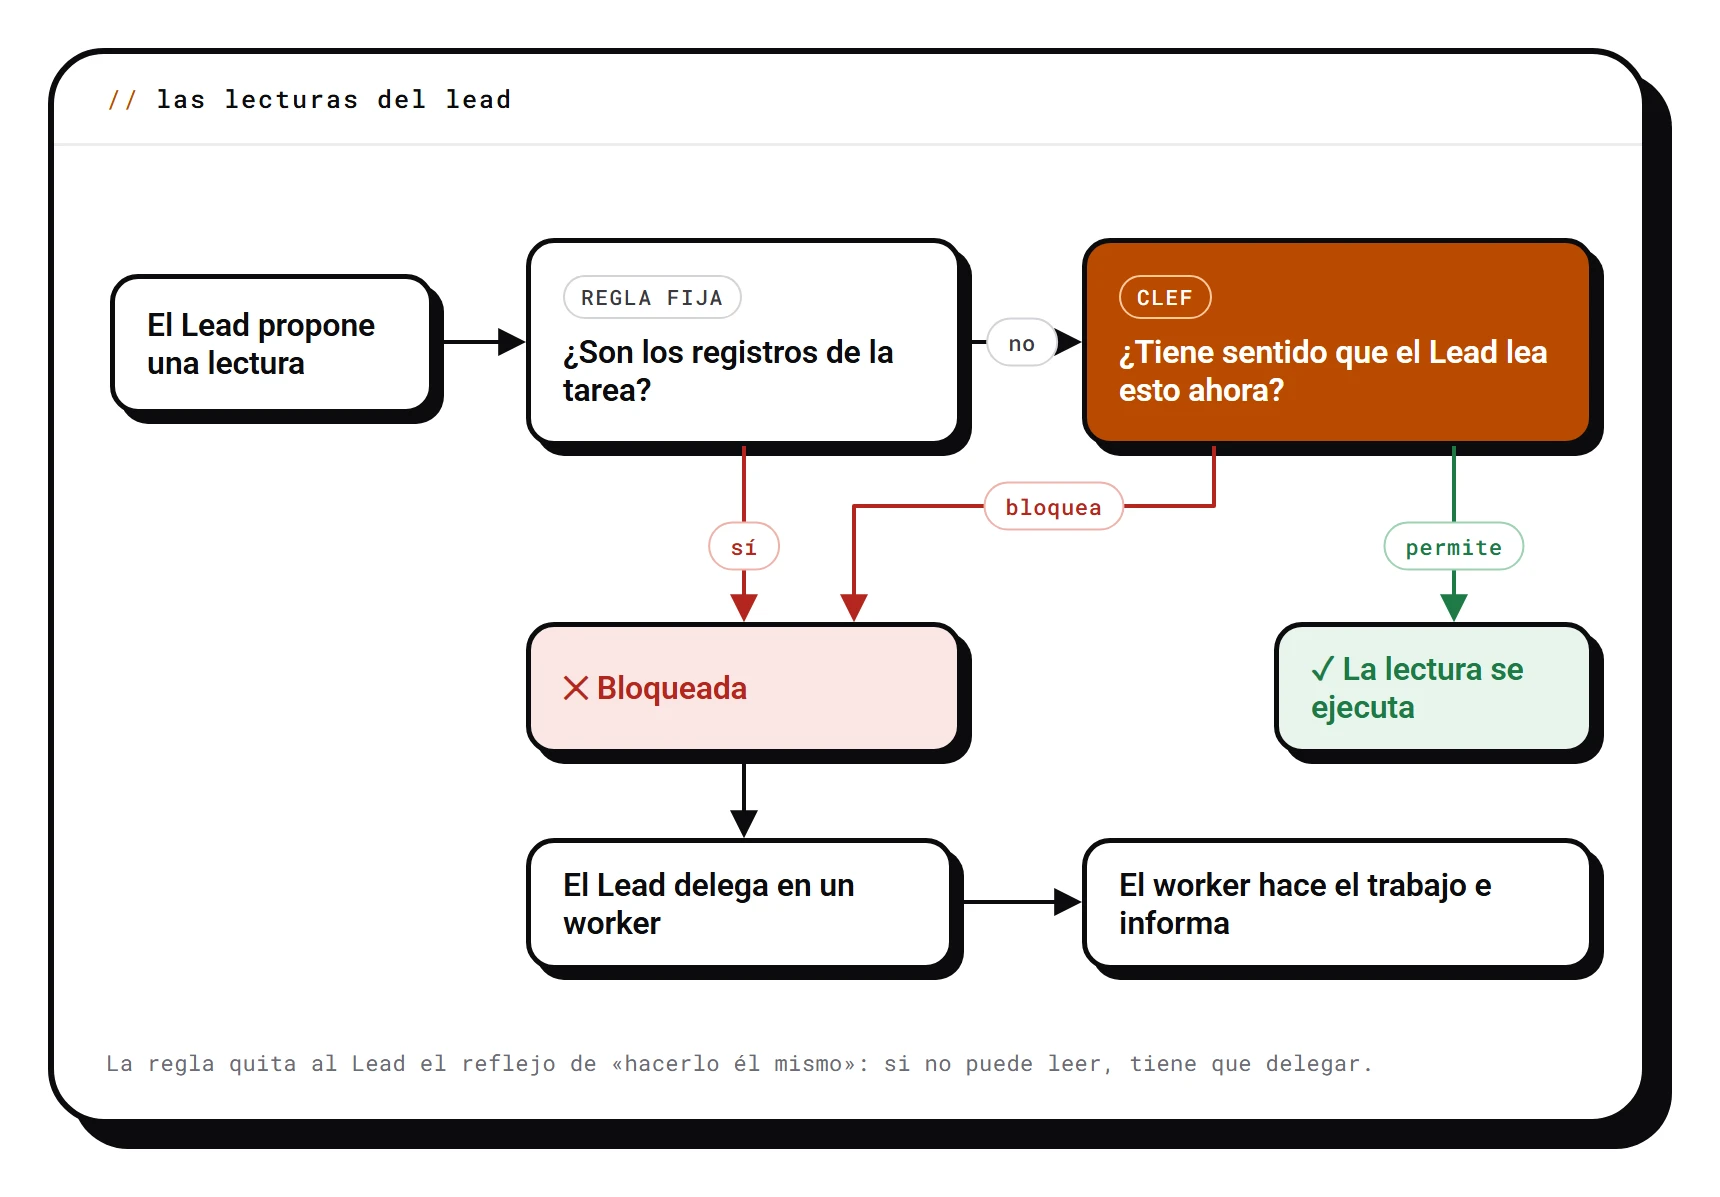
Lo que cambió
El problema de los modelos open weight actuales es que no les gusta ser jefes. Les gusta hacer. Ese sesgo hacia resolver los pone en clara desventaja en sistemas complejos: su primer instinto es responder la pregunta, no entender las complejidades de la tarea y encontrar a los mejores agentes para sacarla adelante.
Clef los obliga a repensar sus acciones con indicaciones precisas y constantes. Este bucle de feedback, rápido y barato, cambia de forma fundamental la dinámica de trabajo.
Los resultados del experimento
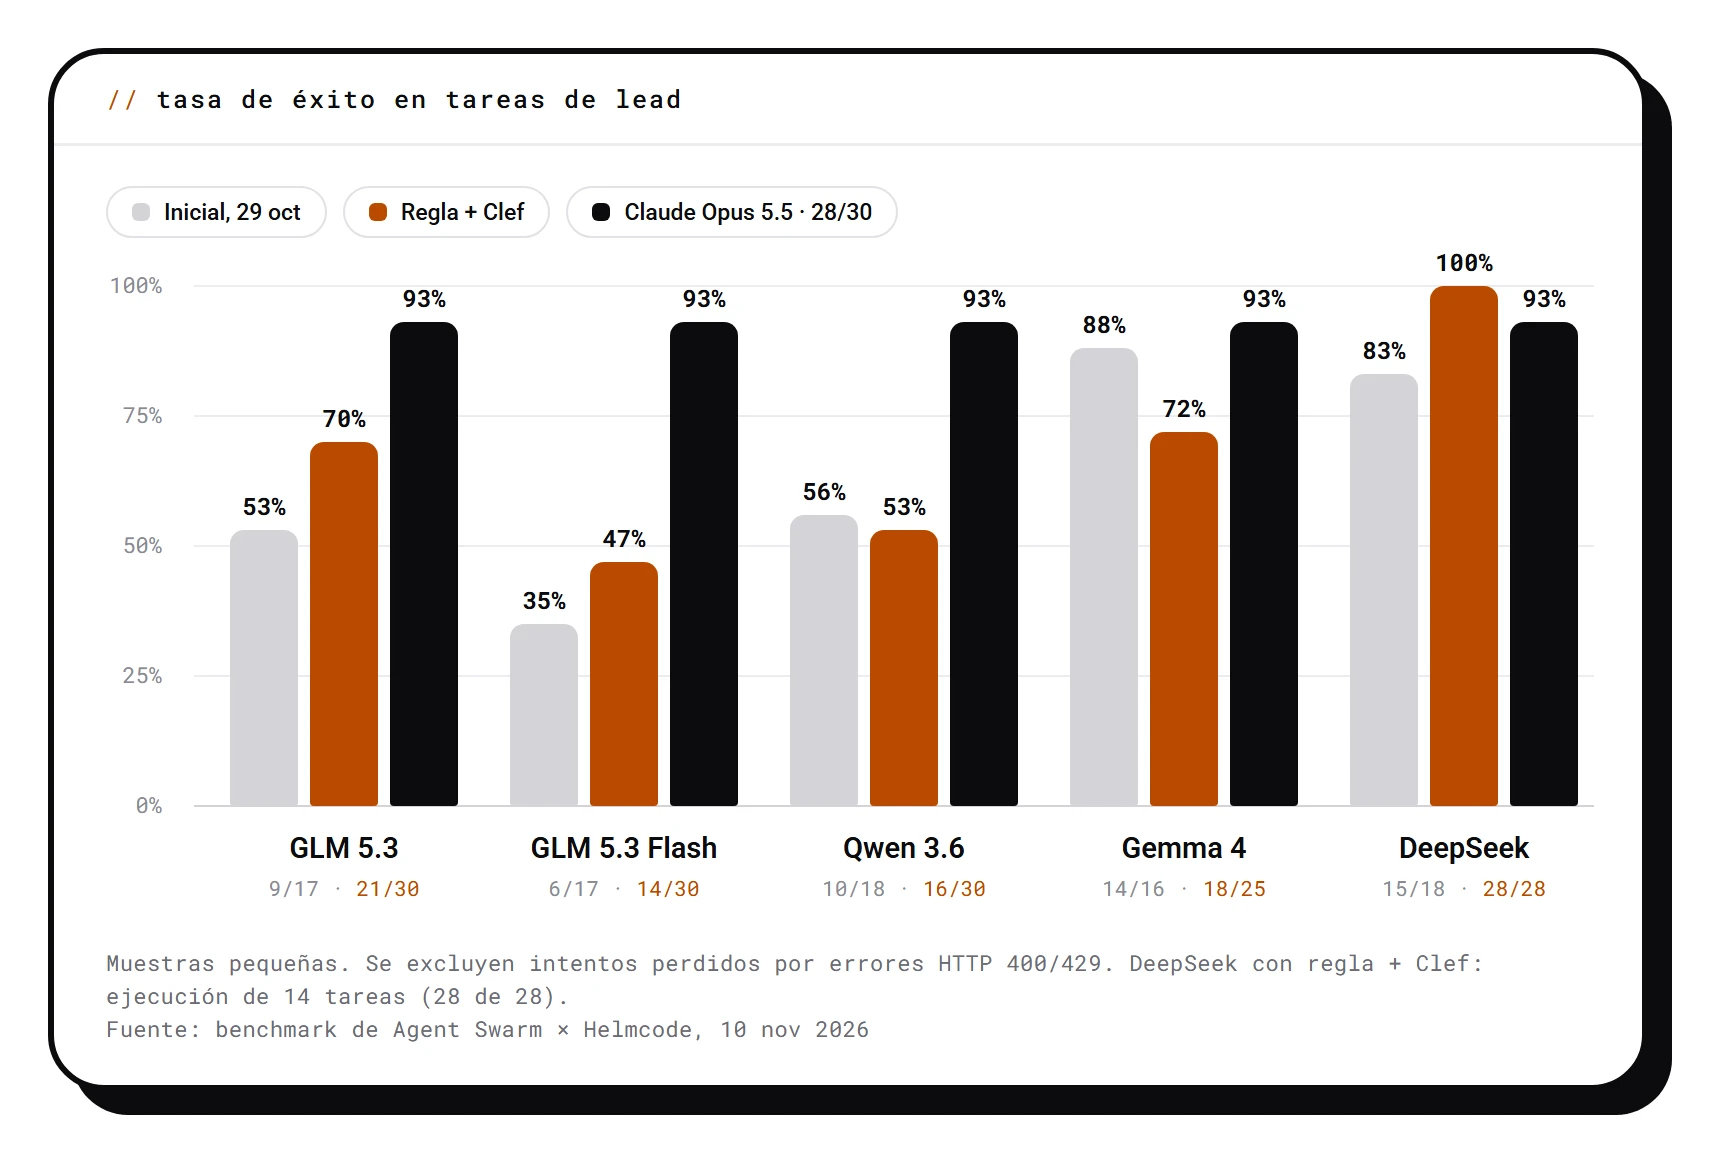
| Modelo | Inicial (29 oct) | Regla + Clef | Claude Opus 5.5 |
|---|---|---|---|
| GLM 5.3 | 53 % (9/17) | 70 % (21/30) | 93 % (28/30) |
| GLM 5.3 Flash | 35 % (6/17) | 47 % (14/30) | 93 % (28/30) |
| Qwen 3.6 | 56 % (10/18) | 53 % (16/30) | 93 % (28/30) |
| Gemma 4 | 88 % (14/16) | 72 % (18/25) | 93 % (28/30) |
| DeepSeek | 83 % (15/18) | 100 % (28/28) | 93 % (28/30) |
Fuente: [benchmark de Agent Swarm × Helmcode](https://api.desplega.agent-swarm.dev/p/ab1bf515eb3a4f819d725fe29ac2c058), 10 de noviembre de 2026.
El resultado de DeepSeek
DeepSeek pasa del 83 % de acierto al 100 %.
Como coordinador, DeepSeek por sí solo no es tan bueno como con Clef y las reglas, que lo elevan al 100 % de éxito en todas las ejecuciones del experimento.
Lo más importante es la comparación con el resto de modelos y con Opus 5.5, que se queda en un 93 % con dos ejecuciones fallidas.
El resto de modelos
No todos mejoran. GLM 5.3 y GLM 5.3 Flash sí consiguen una mejora sustancial, mientras que Qwen 3.6 y Gemma 4 empeoran.
Esto es importante: la arquitectura no funciona igual en todos los modelos. Quizá los modelos con menos capacidad de razonamiento no toman mejores decisiones con un modelo decisor por encima.
Metodología
Conviene leer estos números con cautela:
- Las muestras son pequeñas, y el número de intentos varía entre modelos y configuraciones (de 16 a 30).
- El 28 de 28 de DeepSeek con regla + Clef corresponde a una ejecución de 14 tareas.
- Los harness no son idénticos: Opus 5.5 se ejecutó sobre Claude Code (25 de octubre) y los modelos abiertos sobre OpenCode.
- Se excluyen los intentos perdidos por errores de infraestructura de Helmcode (HTTP 400 y 429), que en algunas ejecuciones se dispararon.
Los datos completos están en la página del benchmark .
Hallazgos que nos parecen importantes
El modelo no trabaja aislado
Cuando evaluamos modelos solemos fijarnos en sus capacidades, sus benchmarks y su precio. Pero un agente también depende del harness, de las herramientas, de cómo gestiona el contexto y de las decisiones que toma el sistema.
Este experimento es un buen ejemplo de cómo esos elementos pueden cambiar el resultado.
No todas las decisiones tienen que pasar por un LLM generalista
Agent Swarm ha publicado varios estudios al respecto: sobre cuánto ahorra automatizar decisiones y sobre cómo sus agentes «sueñan» cada noche . Lo importante es entender que un sistema agéntico debe buscar determinismo: para ganar en velocidad, coste y calidad, hay que usar la herramienta adecuada para cada tarea. En este caso, código y modelos «System One».
El sistema tiene que aprender qué decisiones se pueden resolver con reglas, cuáles con modelos de decisión y cuáles necesitan de verdad un razonamiento más complejo. No es trivial: requiere examinar constantemente la actividad del sistema para detectar esas oportunidades.
Qué significa esto para los modelos abiertos
Lo que ves el día 1 puede estar muy lejos de los resultados una semana después.
Es innegable que casi todos los modelos abiertos están un paso (o varios) por detrás de los cerrados. Por eso, mejorar su fiabilidad mediante la arquitectura, y más aún con otros modelos abiertos como Clef, puede hacerlos competitivos en más tareas sin tener que aumentar continuamente el tamaño del modelo.
Siguientes pasos
Vamos a montar un sistema más complejo con estos mismos principios, para ver si estos resultados se reproducen en escenarios mucho más exigentes que nuestro benchmark.
¿Qué pasaría si pusiéramos esta misma arquitectura a revisar PR, en una *software factory*, a atender incidencias de guardia o a hacer revisiones de seguridad?
El objetivo será comprobar si los resultados se mantienen y comparar configuraciones más equivalentes.
Gracias a Eze y Taras por diseñar y ejecutar el experimento. Puedes conocer más sobre Agent Swarm y consultar el benchmark completo .